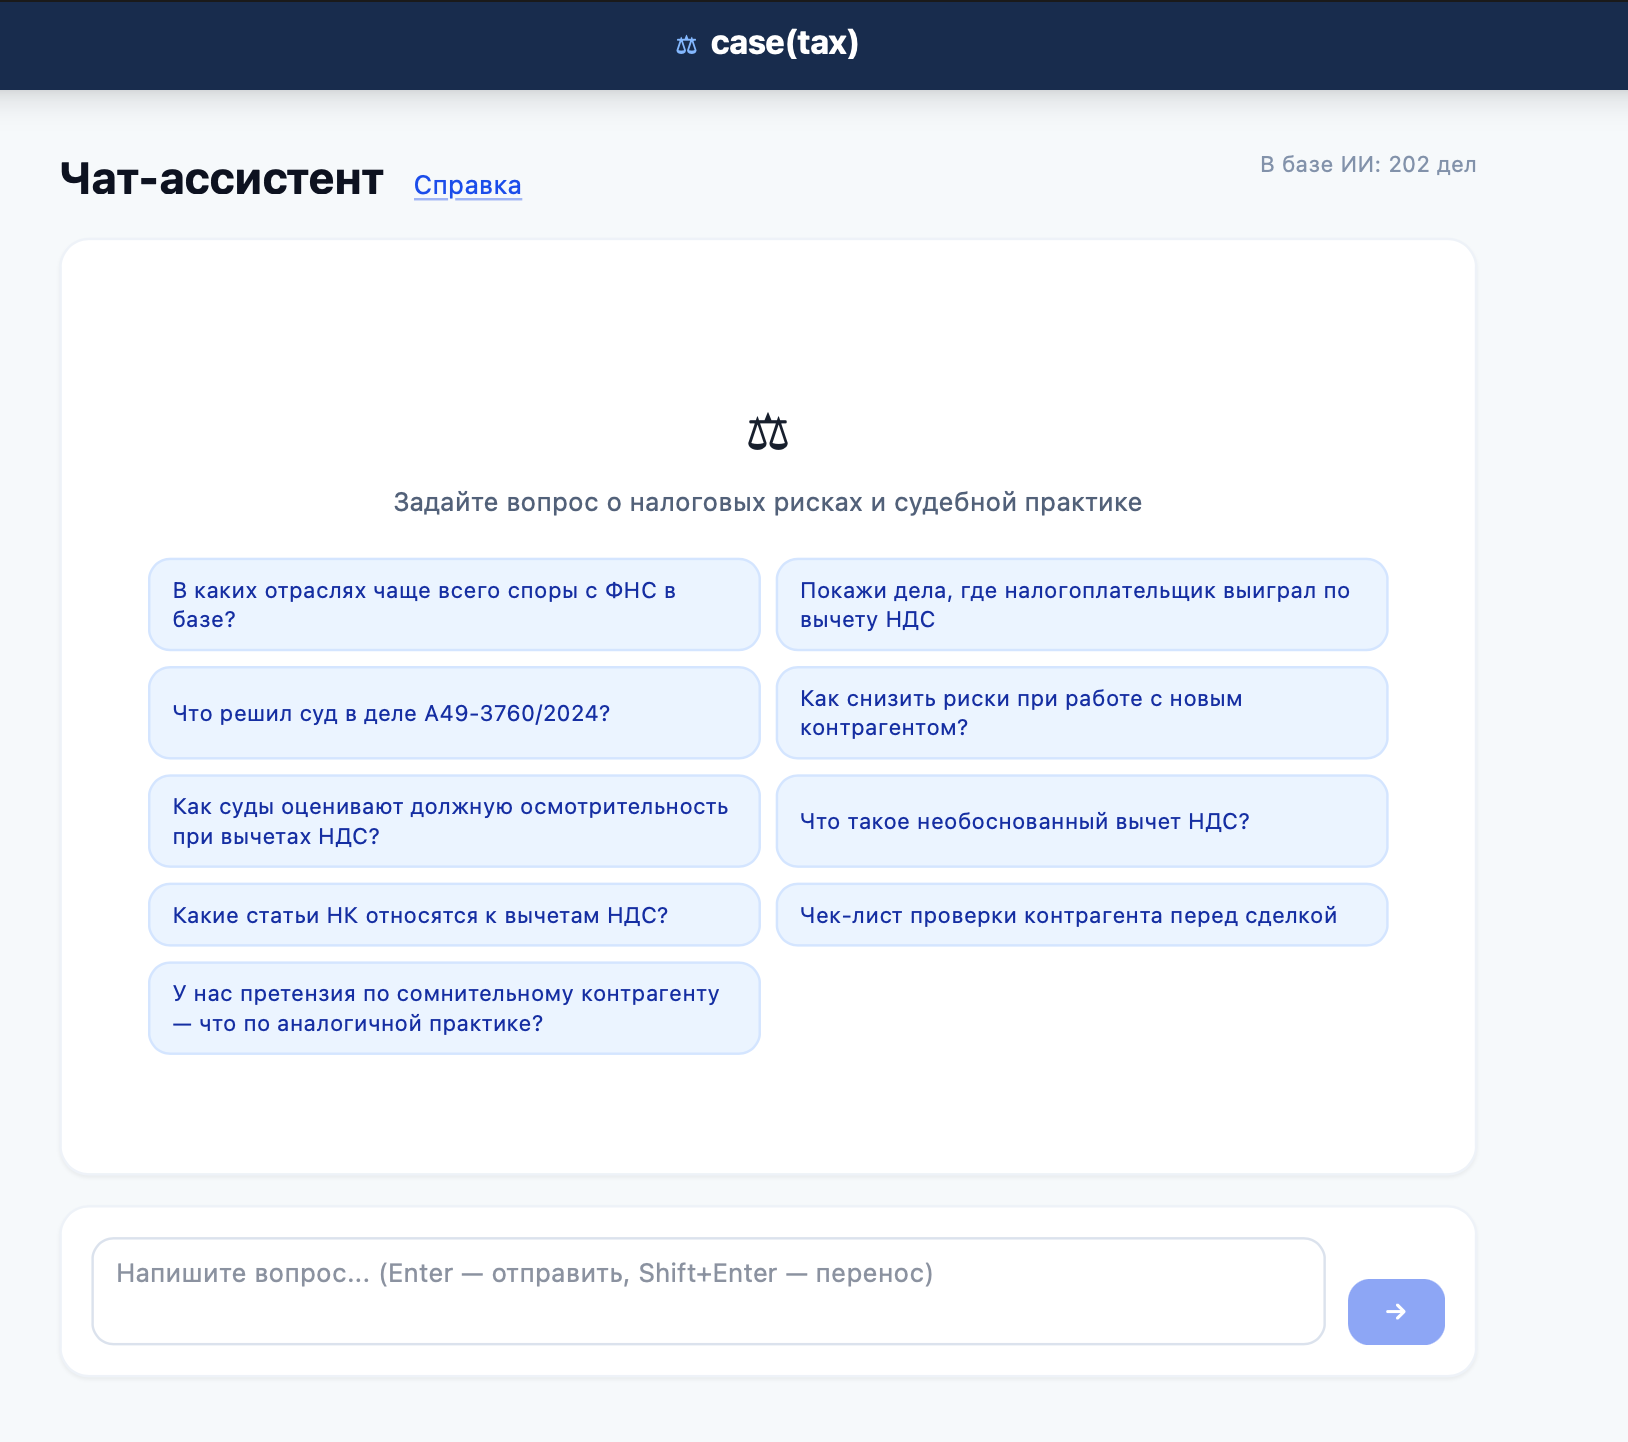
Контекст проекта
В рамках хакатона ВШЭ наша команда работала над кейсом компании «ПравоТех». Требовалось разработать AI-пайплайн, который выявляет налоговые риски по судебным актам и формирует структурированный ответ со ссылками на источники.
На решение кейса отводилось две недели. Конечный вариант прототипа был реализован за четыре дня. Его рабочее название — CaseTax.
По смыслу задача относилась к классу систем, которые можно назвать интеллектуальными ассистентами для юриста. Пользователь ожидает получить прикладной ответ, основанный на конкретных документах и пригодный для проверки. Для этого недостаточно подключить языковую модель к массиву судебных актов. Сначала документы нужно превратить в управляемую базу знаний.
Ниже разобраны основные решения, принятые при проектировании MVP, их ограничения и возможные направления развития.
Первая проблема: что считать налоговым риском
Сложность возникла уже на уровне постановки задачи. В кейсе в качестве примеров налоговых рисков приводились:
- получение необоснованной налоговой выгоды;
- переквалификация гражданско-правовых договоров в трудовые отношения;
- доначисление НДС.
Эти примеры относятся к разным уровням правового анализа. Необоснованная налоговая выгода представляет собой правовую квалификацию поведения налогоплательщика. Переквалификация договора меняет юридическую природу отношений и влечет налоговые последствия. Доначисление НДС чаще выступает финансовым результатом нарушения, причём причины такого доначисления могут различаться.
Без формализации система будет смешивать признаки, причины, квалификацию и последствия. Поэтому риск в прототипе описывается через онтологию — предметную модель со следующей структурой:
- код и название риска;
- описание и юридическая природа;
- правовая база: нормы, судебные позиции и смежные основания;
- подтипы риска, например различные схемы дробления бизнеса;
- общие и специальные признаки-триггеры;
- правила разграничения со смежными рисками;
- последствия: доначисления, штрафы, пени и процессуальные эффекты;
- меры снижения риска;
- поисковые и отраслевые теги.
Такая структура задает контекст для классификации. Одно упоминание НДС в судебном акте еще не свидетельствует о риске необоснованного вычета. Система должна учитывать предмет спора, фактические признаки и примененные нормы. Само доначисление НДС при этом может фиксироваться как последствие выявленного риска — например, дробления бизнеса или использования фиктивного контрагента.
Два контура вместо одного общего конвейера
Архитектура MVP разделена на два контура:
- Контур пополнения базы знаний обрабатывает судебные акты и формирует структурированные карточки дел.
- Контур чата принимает вопросы пользователя и отвечает по подготовленному корпусу.
Такое разделение отделяет извлечение знаний из документов от генерации пользовательского ответа. В чат поступают уже обработанные данные, а не сырой массив судебных актов.
Контур пополнения базы знаний
Первый контур реализован как граф обработки документа на базе LangGraph. Узлы читают и последовательно дополняют общее состояние дела. В графе есть условные переходы: нерелевантный документ может быть исключен после диагностики, а результат с проблемами качества — направлен на повторную валидацию или извлечение.
В штатном сценарии судебный акт проходит следующие этапы.
1. Диагностика
Система определяет, относится ли документ к предмету анализа, и извлекает основные метаданные: номер дела, суд, стороны, инстанцию и тип документа. Нерелевантные материалы завершают обработку на этом этапе.
2. Смысловое разделение акта
Судебное решение содержит разные по функции фрагменты: обстоятельства дела, позицию налогового органа, возражения налогоплательщика, оценку доказательств, мотивировку и резолютивную часть.
Для языковой модели соседство этих фрагментов создает риск смешения ролей. Довод инспекции можно ошибочно принять за установленный судом факт, а аргумент налогоплательщика — за итоговый вывод. Поэтому акт сначала разделяется на смысловые части.
3. Извлечение фактов и цитат
Следующий узел извлекает обстоятельства спора, сведения о налогоплательщике и контрагентах, ссылки на нормы, признаки возможных рисков и цитаты. Результат сохраняется в структурированном виде и передаётся последующим узлам.
4. Определение отрасли
Отраслевая принадлежность входит в структуру каталога рисков. Она помогает уточнить контекст дела и использовать отраслевые фильтры при поиске. В прототипе отрасль определяется отдельным шагом с указанием источника и уровня уверенности.
5. Классификация по онтологии
Классификатор сопоставляет извлеченные факты с описаниями рисков, подтипами, триггерами и правилами разграничения. Например, для дробления бизнеса значимы общая инфраструктура, единый персонал, аффилированность участников и распределение выручки для сохранения специальных налоговых режимов.
Языковая модель здесь выполняет локальную смысловую задачу. Ее выбор ограничен онтологией и структурой ожидаемого результата.
6. Валидация
Валидация объединяет алгоритмические и модельные проверки:
- цитаты сверяются с исходным текстом судебного акта;
- фрагментам назначаются роли: позиция налогового органа, вывод в пользу налогоплательщика, смягчающее обстоятельство или нейтральный контекст;
- проверяется согласованность фактов, классификации и цитат;
- замечания могут быть переданы на повторную проверку или новое извлечение.
Это не заменяет юридическую экспертизу. Задача слоя — обнаружить технические несоответствия до сохранения результата: отсутствующую цитату, неверно определённую роль фрагмента или противоречие между фактами и классификацией.
7. Формирование карточки дела
Финальный узел собирает структурированную карточку дела. Она включает:
- метаданные судебного акта;
- выявленный риск из онтологии;
- фактическое и правовое основания;
- признаки риска;
- последствия и меры снижения;
- исход спора и отрасль;
- проверенные цитаты;
- оценку уверенности и служебные сведения о прохождении обработки.
Структурированные результаты сохраняются в PostgreSQL. Это основное хранилище карточек дел. Для семантического поиска используется отдельный индекс на базе pgvector, куда попадают только допущенные записи и связанные с ними цитаты. Векторный индекс служит инструментом поиска, но не подменяет основную базу результатов.
Ручная проверка как ограничение MVP
За время хакатона полноценно проверить весь корпус судебных актов было невозможно. Для демонстрационного сценария часть карточек отобрали и верифицировали вручную, после чего включили в поисковый индекс чата.
Это было прагматичным ограничением прототипа. Автоматически сформированная карточка и источник, допущенный к пользовательским ответам, имеют разный статус. Между ними требуется процедура допуска. В дальнейшем она может сочетать экспертную проверку, автоматические тесты качества и пороги уверенности.
Контур чата
Чат служит интерфейсом к подготовленной базе знаний. Пользователь может запросить подборку дел, сведения о конкретном споре, анализ практики, меры снижения риска, правовые нормы, чек-лист или статистику по корпусу.
Все запросы проходят через единый оркестратор. Это не набор полностью независимых пайплайнов: последовательность основных шагов общая, но поведение системы зависит от типа вопроса.
1. Классификация запроса
Классификатор определяет тип вопроса, темы, фильтры и политику ответа. Запрос вне предмета корпуса помечается отдельно, чтобы система не подбирала к нему формально похожие налоговые дела.
2. Поиск
Для большинства запросов выполняется семантический поиск по карточкам дел и цитатам. Для статистики и вопросов вне предметной области поиск пропускается. При запросе конкретного дела глубина поиска увеличивается, чтобы получить достаточно дословных фрагментов.
3. Загрузка полных карточек
Результаты семантического поиска используются как кандидаты. Затем система получает полные карточки из основного хранилища, применяет фильтры и при необходимости добавляет текст дела.
4. Добавление онтологии
По кодам выявленных рисков в контекст включаются применимые нормы и судебные позиции из онтологии. Благодаря этому ответ опирается одновременно на факты конкретных дел и предметную модель риска.
5. Проверка допустимости ответа
Перед генерацией валидатор оценивает, можно ли отвечать по имеющимся данным. Запрос о содействии незаконным действиям отклоняется, отсутствие конкретного дела или пустая подборка приводит к уточняющему сообщению. Для статистики результат рассчитывается преимущественно детерминированно по данным карточек.
6. Формирование ответа
Формат и системные инструкции зависят от типа запроса. В контекст передаются карточки дел, цитаты, нормы и явный список допустимых номеров дел. Последнее ограничивает возможность сослаться на дело, которого нет среди найденных источников.
Таким образом, чат управляет глубиной и составом контекста, сохраняя связь ответа с проверяемыми карточками и судебными актами.
Где здесь агентность
Вокруг агентных систем сформировался заметный ажиотаж. Отсюда возникает соблазн сразу проектировать свободного агента, который самостоятельно выбирает стратегию исследования, инструменты и источники. В этом MVP мы выбрали более консервативную архитектуру.
Для юридического ассистента критично качество базового слоя: корпуса документов, онтологии, извлеченных цитат, поисковых инструментов и правил проверки. Расширение свободы агента до решения этих вопросов увеличивает число точек, в которых ошибка может закрепиться и повлиять на следующие шаги.
Агентность в прототипе проявляется локально:
- узлы анализа интерпретируют фрагменты, выбирают существенные признаки и соотносят дело с онтологией;
- граф принимает ограниченные решения о релевантности документа и повторной проверке;
- чат классифицирует запрос и меняет поиск, глубину контекста, правила валидации и формат ответа;
- модель формирует вывод в пределах найденных дел и переданных ограничений.
Такую архитектуру можно описать как контролируемую оркестрацию с элементами прикладной агентности. Она не ставит цели самостоятельно и не строит произвольный исследовательский план.
Это различие хорошо объясняет Екатерина Якуненко в статье «RAG в эпоху агентного ИИ: существует ли Agentic RAG? Существует ли вообще ещё RAG?». RAG сам по себе остаётся механизмом поиска и передачи найденного модели. Агентность появляется на уровне системы, которая решает, нужен ли поиск, как сформулировать запрос, какой источник выбрать, достаточно ли найденного материала и когда завершить исследование.
Наш прототип ещё не реализует полный цикл найти → оценить → уточнить → найти снова. Он работает внутри заранее заданного графа и с ограниченным набором источников. При этом в нем уже есть управление контекстом: маршрутизация вопроса, выбор глубины поиска, загрузка карточек, добавление онтологии и проверка допустимости ответа.
Выбор контролируемой оркестрации отражает текущую зрелость инструментов и базы знаний. Для права особенно опасны дрейф поиска, смешение сущностей, каскадирование ошибок и убедительные ссылки на неверно интерпретированные источники.
Ориентиры для развития
Дальнейшее развитие сервиса можно связывать с устройством знаний, по которым работает модель. Несколько исследовательских направлений особенно близки к архитектуре прототипа.
От YAML-онтологии рисков к графу знаний
Одно из возможных направлений развития прототипа — перенести онтологию налоговых рисков из YAML-файлов в граф знаний и использовать ее в GraphRAG. Графовое представление позволит явно зафиксировать отношения между рисками, их признаками, подтипами, правовыми основаниями, последствиями и мерами снижения. Поиск в таком случае сможет возвращать связанный смысловой маршрут, а не набор отдельных близких по формулировке фрагментов.
Одним из ориентиров для этой идеи стал материал *From Legal Documents to Knowledge Graphs*. Его авторы показывают, как сведения из юридических документов можно преобразовать в граф, и формулируют важное ограничение простого векторного поиска: семантическая близость помогает находить похожий текст, но плохо передаёт устойчивые связи между сущностями и правовыми понятиями.
У этого источника есть очевидный коммерческий контекст: он опубликован в техническом блоге компании Neo4j, разработчика одноимённой графовой системы управления базами данных. Поэтому материал нельзя считать нейтральным сравнением векторного и графового подходов. Его практическая ценность в другом: это конкретный инженерный пример преобразования юридической информации в систему явных связей, который помогает сформулировать возможную архитектуру дальнейшего эксперимента.
В нашем случае исходные данные и схема графа будут другими. Его основой станет уже подготовленная онтология: риск соотнесен с подтипами, общими и специальными признаками, нормами и судебными позициями, смежными рисками, последствиями, мерами снижения и отраслевыми тегами. Система сможет пройти, например, от обнаруженного признака к подтипу риска, затем к применимой норме, возможным последствиям и мерам снижения.
Карточки дел при этом остаются отдельным доказательственным слоем. Они связываются с узлами рисков по коду классификации и предоставляют факты, исходы и цитаты из конкретных судебных актов, но не служат исходным материалом для построения самого графа.
Переход к GraphRAG ставит отдельный вопрос: как проверить, какие элементы онтологии действительно повлияли на ответ модели. Авторы исследования *XGRAG: A Graph-Native Framework for Explaining KG-based Retrieval-Augmented Generation* предлагают оценивать вклад отдельных узлов и связей с помощью контролируемых изменений графа и сравнения полученных ответов. Такой подход позволяет анализировать объяснимость на уровне самой структуры знаний, тогда как методы оценки обычного RAG преимущественно работают с извлеченными текстовыми фрагментами.
Для юридического ассистента эта постановка особенно важна: система должна показывать, какие признаки, связи между рисками и правовые основания привели ее к выводу, а карточки дел — подтверждать его фактическими источниками. При этом XGRAG проверялся на общих наборах вопросов и ответов, а не на юридическом корпусе. Поэтому исследование следует рассматривать как ориентир для разработки методики оценки, но не как подтверждение эффективности GraphRAG в правовой сфере.
Структура юридического рассуждения
Авторы работы *Knowledge Graph-Assisted LLM Post-Training for Enhanced Legal Reasoning* моделируют судебные решения через IRAC: Issue, Rule, Analysis, Conclusion. Такой подход показывает ценность структурированного представления юридического рассуждения.
В контексте налоговых споров это означает разделение вопроса, применимого правила, юридически значимых фактов, их анализа и вывода. Текущая карточка дела частично отражает такую структуру через фактическое основание, правовую рамку, признаки, последствия и цитаты.
Разметка аргументов в судебном акте
Исследование *Mining Legal Arguments to Study Judicial Formalism* показывает, что судебные решения можно размечать по типам правовых аргументов. Для нашего прототипа это направление связано с более точной сегментацией и определением роли каждого фрагмента.
Если система не различает позицию налогового органа и вывод суда, спорный довод может быть принят за подтвержденный факт. Более детальная разметка аргументов способна улучшить извлечение, классификацию и объяснимость результата.
Если свести рассмотренные ориентиры к практическому плану, дальнейшая работа может включать:
- расширение и экспертную проверку онтологии рисков, её преобразование в граф знаний и эксперименты с GraphRAG;
- разработку методики оценки GraphRAG, которая позволяет проследить влияние отдельных узлов и связей онтологии на ответ;
- более явное структурирование карточек дел и ответов по элементам юридического рассуждения, в том числе с использованием IRAC;
- детальную разметку ролей фрагментов судебного акта: обстоятельства, доводы сторон, нормы, оценка доказательств и вывод суда;
- автоматизацию допуска карточек в поисковый индекс с сочетанием технических проверок, метрик качества и экспертной верификации;
- контроль актуальности нормативных и судебных источников и версионирование онтологии;
- создание набора тестов для оценки извлечения, классификации, цитирования, поиска и итоговых ответов, включая устойчивость к дрейфу поиска и каскадированию ошибок;
- проверку архитектуры на других налоговых и юридических задачах.
Вывод
Работа над MVP показала, что качество юридического ассистента формируется задолго до генерации ответа. Судебный акт необходимо преобразовать в управляемое знание: отделить факты от позиций сторон, соотнести признаки с онтологией, сохранить точные цитаты и определить статус источника. Без этих операций связный текст лишь скрывает неопределённость исходных данных.
В такой архитектуре языковая модель становится гибким семантическим слоем над элементами, характерными для экспертных систем. Она работает с вариативностью юридического языка, извлекает признаки, принимает локальные классификационные решения и формирует ответ. Надежность обеспечивается окружающей инфраструктурой: предметной моделью, допущенным корпусом источников, ограничениями поиска, валидацией и журналом промежуточных решений.
Агентность в этом контексте продуктивнее рассматривать как набор решений, переданных модели. Чем больше свободы система получает при выборе источника, формулировании запроса, повторном поиске и остановке исследования, тем строже должны быть требования к инструментам и оценке результата. Графовое представление онтологии и методы анализа вклада её элементов дают одно из возможных направлений развития, особенно если позволяют восстановить путь от признаков и правовых оснований к выводу.
Налоговые споры стали частным примером более общей задачи. Те же принципы применимы к договорному анализу, комплаенсу, исследованию судебной практики и подготовке правовых заключений. Зрелость такой системы определяется возможностью воспроизвести ход обработки, проверить источники и установить основание каждого существенного утверждения.
Источники
- Екатерина Якуненко. *RAG в эпоху агентного ИИ: существует ли Agentic RAG? Существует ли вообще ещё RAG?*
- Tomaž Bratanič, Tuana Çelik. *From Legal Documents to Knowledge Graphs*. Neo4j Developer Blog.
- Zhuoling Li et al. *XGRAG: A Graph-Native Framework for Explaining KG-based Retrieval-Augmented Generation*
- Dezhao Song et al. *Knowledge Graph-Assisted LLM Post-Training for Enhanced Legal Reasoning*
- Tomáš Koref et al. *Mining Legal Arguments to Study Judicial Formalism*